L'IA en temps réel pour les artistes
ossia score permet d'exécuter des modèles d'IA en temps réel, comme la détection de pose, la génération d'images ou les modèles de langage, sous forme d'objets d'un patch.
Gratuit et open source (GPLv3) · Windows, macOS, Linux, Raspberry Pi et navigateur web
Dans ossia score, un modèle d’IA s’utilise comme n’importe quel autre objet d’un patch : par exemple, l’image d’une caméra entre, et des positions, des images, du texte ou du son sortent et pilotent le reste de l’œuvre. Les modèles s’exécutent localement sur l’ordinateur ; les objets d’IA n’envoient rien à un service en ligne. Reflet (Noukii, Isabella Salas et Allison Moore, SAT, Montréal, 2025–2026) utilise score pour la logique du spectacle et pour des images produites en temps réel par des modèles génératifs sur mesure.
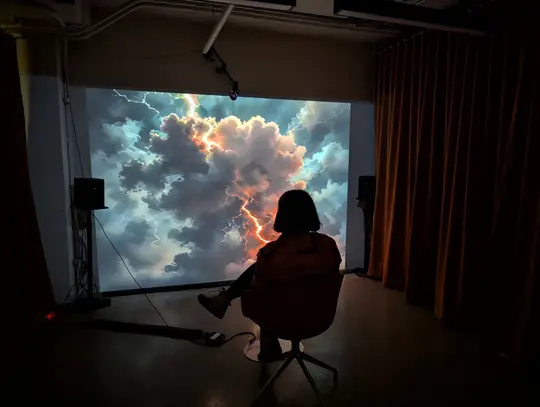
Reflet, Noukii (Anouk Ethier) avec Isabella Salas et Allison Moore, à la SAT : logique du spectacle et images générées en temps réel par des modèles sur mesure dans ossia score. © Agustina Isidori
Pose et vision
À partir d’une simple webcam, score détecte la pose de plusieurs personnes (avec lissage), détecte et segmente des objets, estime les émotions et les maillages du corps, et calcule la profondeur (détection de pose, reconnaissance). Les résultats sont des valeurs ordinaires, que l’on peut transformer en notes MIDI, en messages OSC, en géométrie 3D ou en cues lumière (tracking vers MIDI, tracking vers géométrie).
Génération d’images
StreamDiffusion et librediffusion génèrent des images en temps réel à partir d’une caméra, d’une vidéo ou de contenu généré, avec SD et SDXL Turbo, Flux.2 Klein, ControlNet, IP-Adapter et LoRA (StreamDiffusion) ; ces objets nécessitent Windows ou Linux avec une carte graphique NVIDIA. Les prompts peuvent être composés et interpolés dans le temps, et pilotés par des caméras, des capteurs ou l’analyse audio (compositeur de prompts).
Langage, son et apprentissage
Qwen3 et Gemma 3 peuvent être utilisés comme modèles de langage, et d’autres modèles décrivent un flux vidéo en mots (LLM Qwen) ; pour le son, on dispose de la séparation de pistes et de vocodeurs neuronaux.
Les classifieurs et régresseurs s’entraînent à partir de quelques exemples enregistrés de gestes ou de données de capteurs, et un interpolateur se déplace entre des états appris (classifieur, régresseur). D’autres modèles ONNX peuvent être chargés via un objet générique, sur CUDA, TensorRT, DirectML ou Core ML ; certains fonctionnent aussi dans la version web grâce à WebNN.
Comme tout autre processus, les objets d’IA se placent sur la timeline avec des cues, des scènes et des conditions, de sorte qu’un spectacle qui les utilise puisse être rejoué à l’identique chaque soir.
Gratuit et open source (GPLv3) · Windows, macOS, Linux, Raspberry Pi et navigateur web